PDFs de clientes en ChatGPT: lo que un freelance sube sin darse cuenta
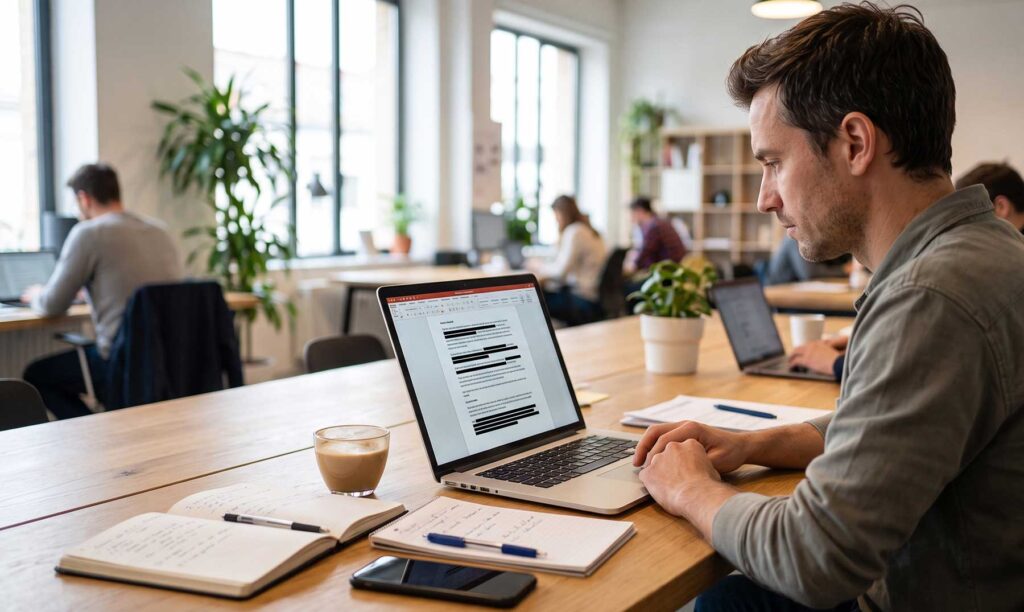
Martes por la mañana en un coworking cualquiera. Tienes el portátil abierto, el café a medias y un contrato de veinte páginas que un cliente te ha mandado para que lo revises antes del viernes. Lo arrastras al chat de ChatGPT, de Claude o de Gemini, pides un resumen de las cláusulas importantes y en un minuto tienes el trabajo encaminado.
Es de las cosas que mejor hace la IA. Lo delicado es lo que va dentro del archivo.
Ese contrato lleva el nombre del cliente, su DNI, su domicilio, quizá un número de cuenta y la firma de la otra parte. Y un PDF guarda más cosas de las que enseña en pantalla: datos del autor, comentarios, capas que no se ven y, a veces, texto que alguien creyó haber tachado.
Si trabajas por tu cuenta con documentos de otros, ya seas gestor, abogado, traductor, diseñador o consultor, conviene saber qué viaja cuando subes un PDF a una herramienta de IA, qué esperan de ti las normas de protección de datos y cómo limpiar el archivo antes, sin perder la comodidad que te ha llevado a usarla.
Qué datos personales lleva un PDF de cliente
Empieza por lo evidente, que es lo que se lee en la página:
- Una factura lleva nombre o razón social, NIF, dirección y a veces el IBAN.
- Un presupuesto de reforma incluye la dirección de la vivienda y el teléfono del propietario.
- Un contrato de arrendamiento suma los datos de las dos partes, los del avalista y la cuenta donde se paga la renta.
- Y un escaneo puede traer la copia del DNI grapada al final.
Luego está lo que no se ve.
El Instituto Nacional de Ciberseguridad (INCIBE) explica que los programas de ofimática suelen guardar en los metadatos el nombre del autor, la ruta interna donde estaba el archivo y el nombre de la organización. Si el PDF salió del Word del cliente, puede llevar su nombre de usuario y la carpeta de su ordenador donde se guardó, que a veces se llama como el propio expediente.
Hay más cosas escondidas: los comentarios que dejó el abogado de la otra parte, los archivos adjuntos o las capas que alguien desactivó para imprimir. Y el nombre del archivo, que viaja con él: un «contrato_Garcia_Lopez_firmado.pdf» le cuenta a cualquiera de quién trata el documento antes de abrirlo.
Por qué el recuadro negro no borra nada
El reflejo habitual es abrir el PDF, dibujar rectángulos negros sobre el nombre y el DNI, guardar y darlo por resuelto. En pantalla queda impecable. Pero un PDF no es una fotografía de la página, sino un conjunto de instrucciones que el visor ejecuta por orden: escribir este texto aquí, dibujar esta línea allá, pintar un rectángulo encima.
El rectángulo negro es una instrucción más que se pinta después y tapa lo de debajo a la vista, pero no lo elimina. Las letras siguen en el archivo, con su posición y su fuente. Basta con seleccionar todo el texto, copiarlo y pegarlo en un bloc de notas para que el nombre y el DNI aparezcan enteros, como si nadie los hubiera tocado.
Con los escaneos pasa algo parecido. Muchos escáneres de oficina pueden guardar el PDF con reconocimiento de texto, que añade una capa invisible con las palabras encima de la imagen para que se pueda buscar en ella. Si pintas un recuadro sobre la imagen, esa capa invisible sigue intacta debajo, y con ella todos los datos que creías haber escondido.
Lo que lee la IA cuando le das un PDF
La pregunta práctica es qué recibe el modelo cuando sueltas el archivo en el chat.
Anthropic lo explica en la documentación técnica de Claude: el sistema convierte cada página en una imagen, extrae el texto de cada página y le entrega al modelo las dos cosas juntas. Si el texto está en el archivo, aunque no se vea, cuenta con que el asistente lo lee.
En la práctica esto significa que un recuadro dibujado protege muy poco. La imagen de la página enseña el negro, pero el texto extraído trae el nombre debajo. Y con un escaneo sin capa de texto ocurre lo contrario: no hay nada que extraer, pero un modelo que ve la imagen de la página puede leer el DNI igual que lo lees tú.
Una vez subido, el documento ha salido de tu ordenador, y lo que pase con él depende del proveedor y de cómo tengas configurada la cuenta. Lo que sí controlas por completo es qué datos llegan. Esa decisión se toma antes de arrastrar el archivo, y es la única que no admite marcha atrás.
Lo que dicen el RGPD y la LOPDGDD cuando trabajas con datos ajenos
Cuando un cliente te pasa documentos con datos de terceros para que hagas un trabajo, lo normal es que actúes como encargado del tratamiento. El artículo 28.2 del RGPD es claro con esa figura: el encargado no puede recurrir a otro encargado sin autorización previa por escrito, específica o general, del responsable. Si la herramienta de IA trata esos datos por tu cuenta, es justo eso.
A eso se suma el principio de minimización del artículo 5.1.c, que pide que los datos sean adecuados, pertinentes y limitados a lo necesario para cada fin. Para resumir las obligaciones de un contrato, la IA no necesita el DNI del arrendatario ni su cuenta bancaria. Y el artículo 5 de la LOPDGDD añade un deber de confidencialidad que complementa el secreto profesional de abogados, gestores o médicos.
La propia Agencia Española de Protección de Datos predica con el ejemplo. En su política interna sobre IA generativa, en la versión del 27 de noviembre de 2025, establece para las soluciones externas la prohibición expresa de introducir información personal, confidencial o no publicada. No es una norma para autónomos, pero indica con bastante claridad por dónde va el criterio del regulador.
Cómo anonimizar un PDF antes de subirlo a la IA
Si tienes Acrobat Pro, la herramienta buena se llama Censurar. Adobe explica en su tutorial en español, actualizado el 3 de mayo de 2026, que solo está en Acrobat Pro, Premium y Studio. Marcas el texto, usas la búsqueda para encontrar cada repetición, pulsas Aplicar y después Continuar, para quitar también la información oculta, que el tutorial concreta en comentarios, metadatos o capas ocultas.
Sin Acrobat Pro también hay salida. Si solo quieres una respuesta y no un archivo, copia el texto del PDF, pégalo en un editor, quita los datos y pásale eso a la IA. Esta guía explica con una prueba real cómo quitar los datos personales de un PDF antes de usar la IA, qué métodos borran de verdad y cómo comprobarlo en treinta segundos.
Hagas lo que hagas, comprueba el archivo guardado antes de subirlo. Selecciona todo, copia, pega en un bloc de notas y busca el nombre, el DNI y la cuenta con sus variantes, con y sin puntos, solo el apellido o solo los últimos dígitos. Cambia también el nombre del archivo. Si algo aparece, el tachado no ha funcionado y toca repetir.
Una rutina para el portátil del coworking
Cuando trabajas con muchos clientes, lo que te expone es la costumbre más que un documento concreto. El primer paso es separar las tareas: para pedir un resumen, una revisión de estilo o una traducción, la IA casi nunca necesita saber quién firma. Pregúntate antes de arrastrar el archivo qué datos hacen falta de verdad para lo que vas a pedir.
El segundo es que el paso de limpieza no dependa de acordarse cada vez. Hay herramientas pensadas para eso. Nonimo, por ejemplo, es una aplicación para Mac y Windows que detecta nombres, números de DNI, IBAN y otros datos personales y los sustituye por marcadores en el propio ordenador antes de que el texto llegue a la IA, que trabaja igual pero sin el dato real.
El tercero es dejarlo por escrito. Si tus clientes te piden un contrato de encargado del tratamiento, menciona cómo usas la IA y qué datos no entran nunca en ella. Una línea clara en ese documento te ahorra explicaciones después, y el cliente sabe a qué atenerse cuando te manda el siguiente expediente.